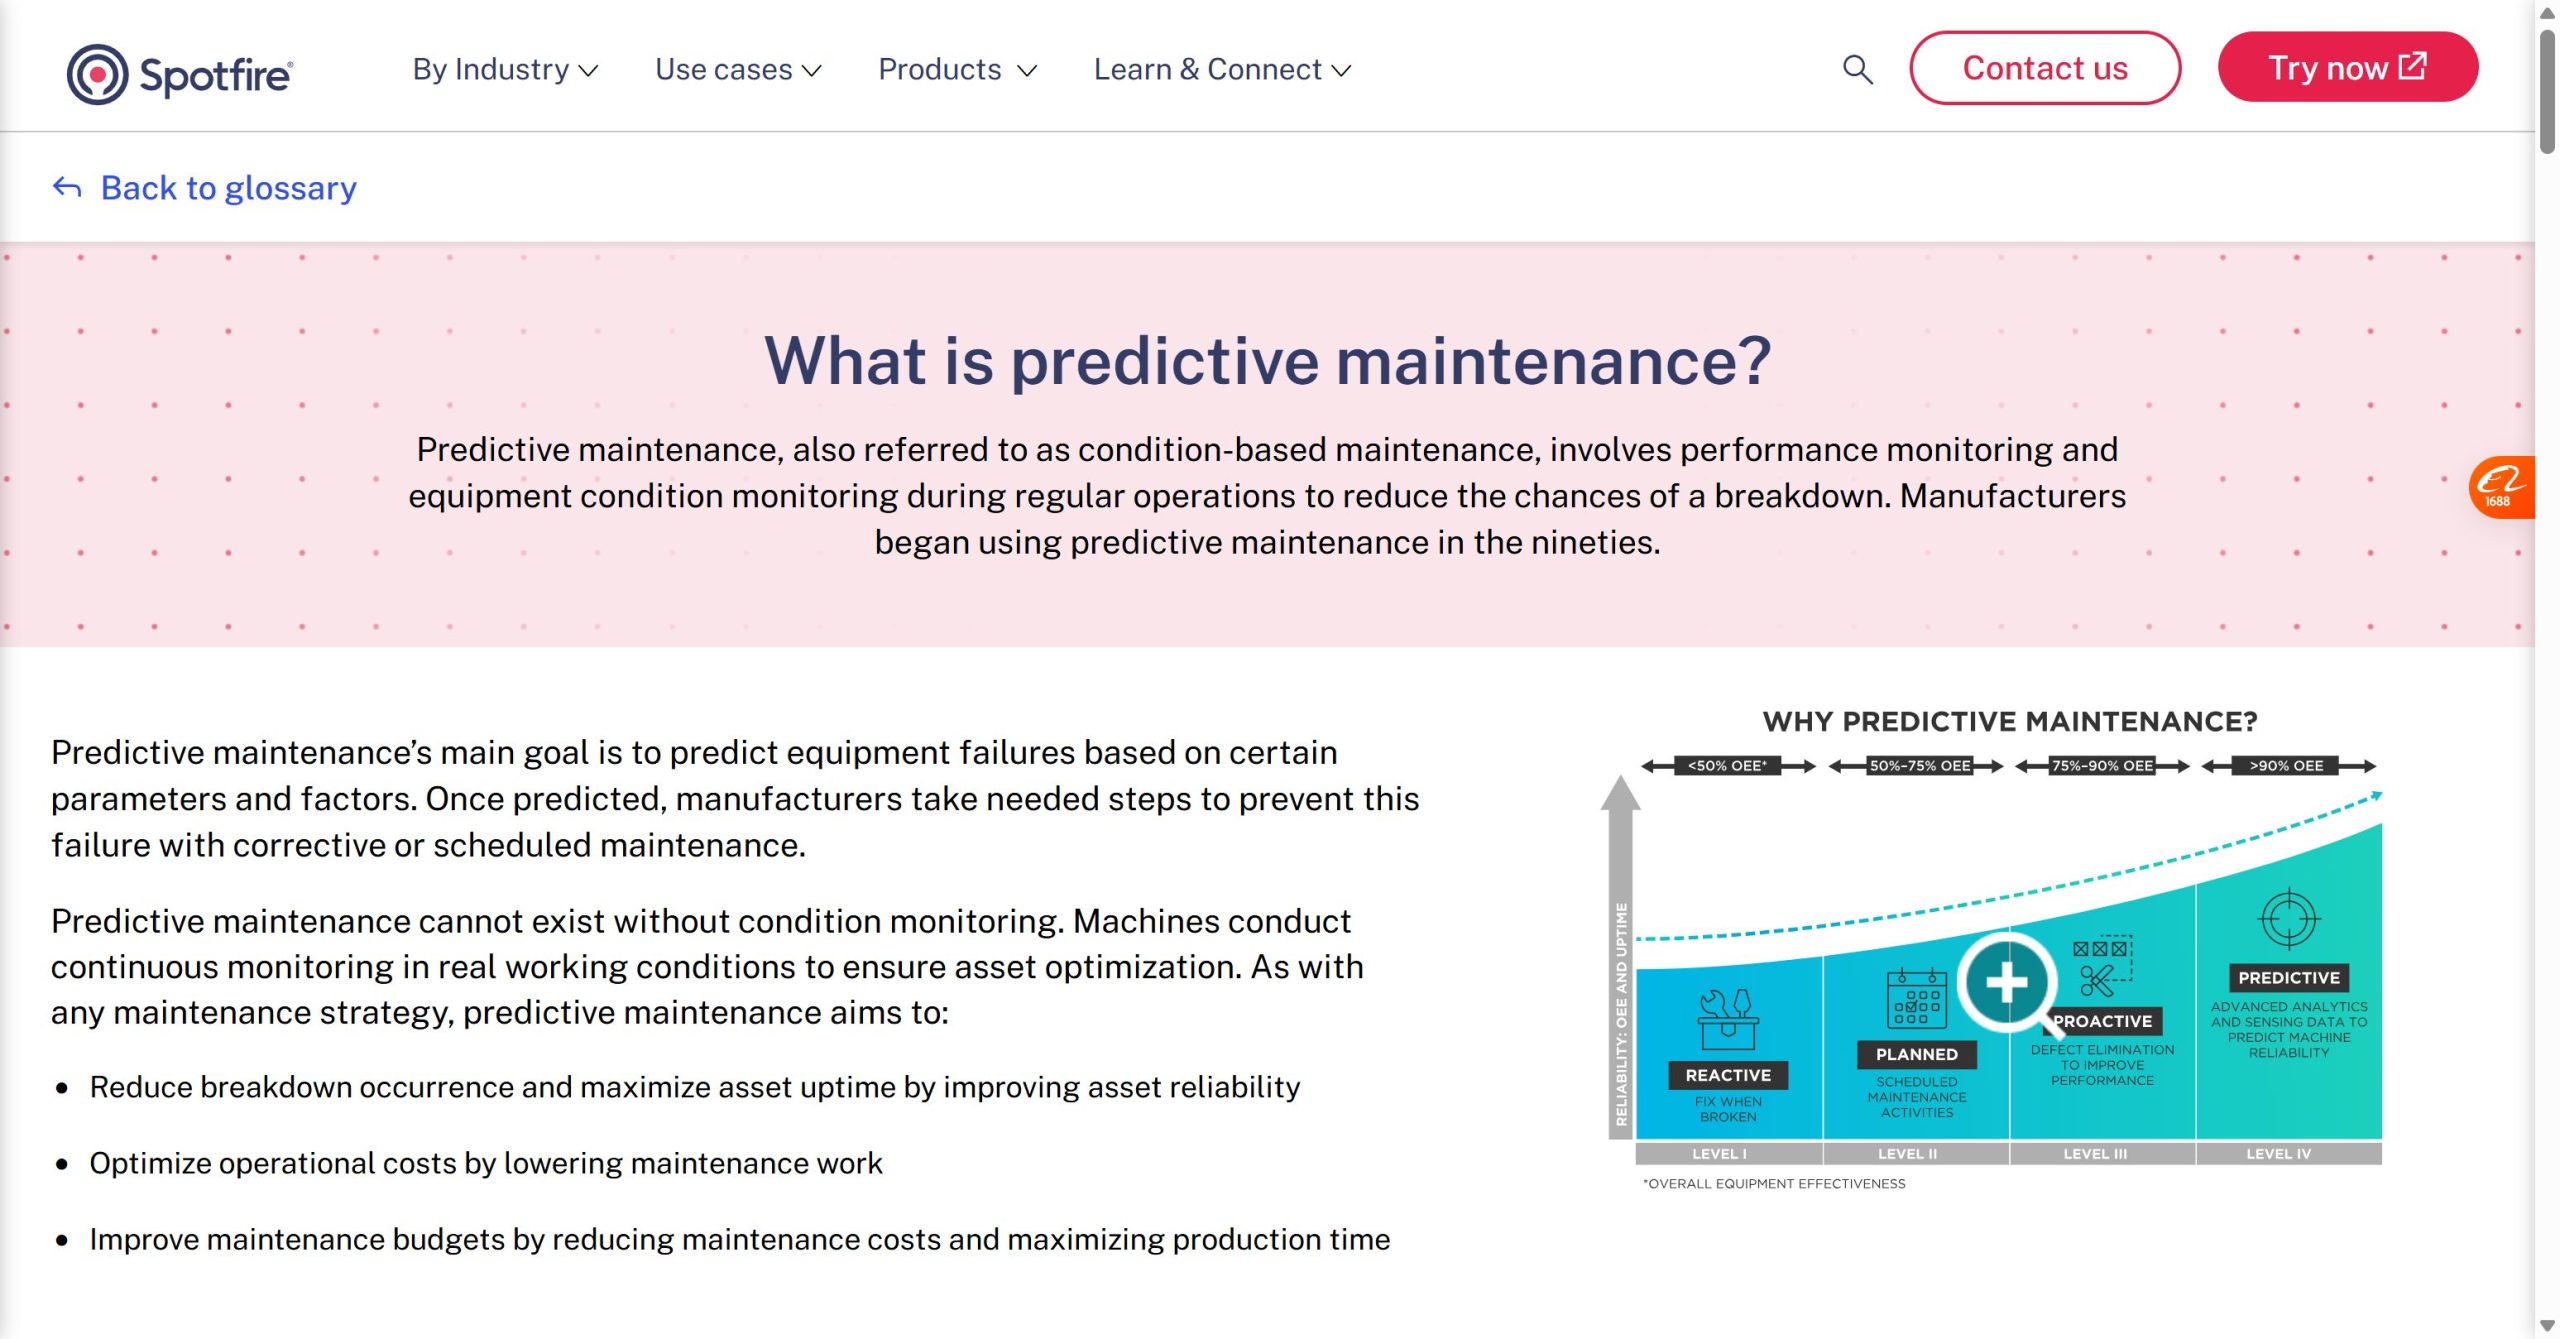
在大多数工厂里,设备维护只有两种模式:定期检修和故障抢修。前者”没坏也修”,浪费备件和人力;后者”坏了才发现”,一次非计划停机就可能带走几十万的产值。预测性维护要解决的就是这个两难:让维护发生在”刚刚好”的时间点。
实现它的关键不是装更多传感器,而是把已经存在的传感器数据、维保记录和工况数据真正分析起来。本文介绍 Spotfire 在设备预测性维护中的典型用法,以及三个不同行业的实际效果。
传统维护模式的两个陷阱
定期检修按日历或运行时长安排,假设设备损耗是均匀的。但现实中,设备的健康状态随负载、环境、原料批次波动——同一型号的泵,在干净工况和含颗粒工况下的寿命可以差一倍。按平均寿命检修,必然是一部分设备”修早了”,另一部分”没撑到检修就出故障”。
故障抢修的问题更直接:非计划停机发生在生产节拍之外,连带产生加急备件、加班人工、订单交付延误。对于连续生产的流程工业,一次关键设备停机还可能引发整条线的质量波动。
预测性维护的核心思路:不再按时间表维护设备,而是按设备的实际健康状态维护。传感器数据告诉你它”还能撑多久”,维护窗口由此安排在生产计划的空档里。
Spotfire 是怎么做预测性维护的
数据从哪来
预测性维护需要的数据,大多数工厂其实已经具备:
- 实时传感数据:振动、温度、电流、压力、声学信号等,来自机台自带传感器或后装的 IoT 采集装置;
- 历史维保台账:故障记录、备件更换时间、维修工单;
- 工况与环境数据:负载、转速、原料批次、车间温湿度。
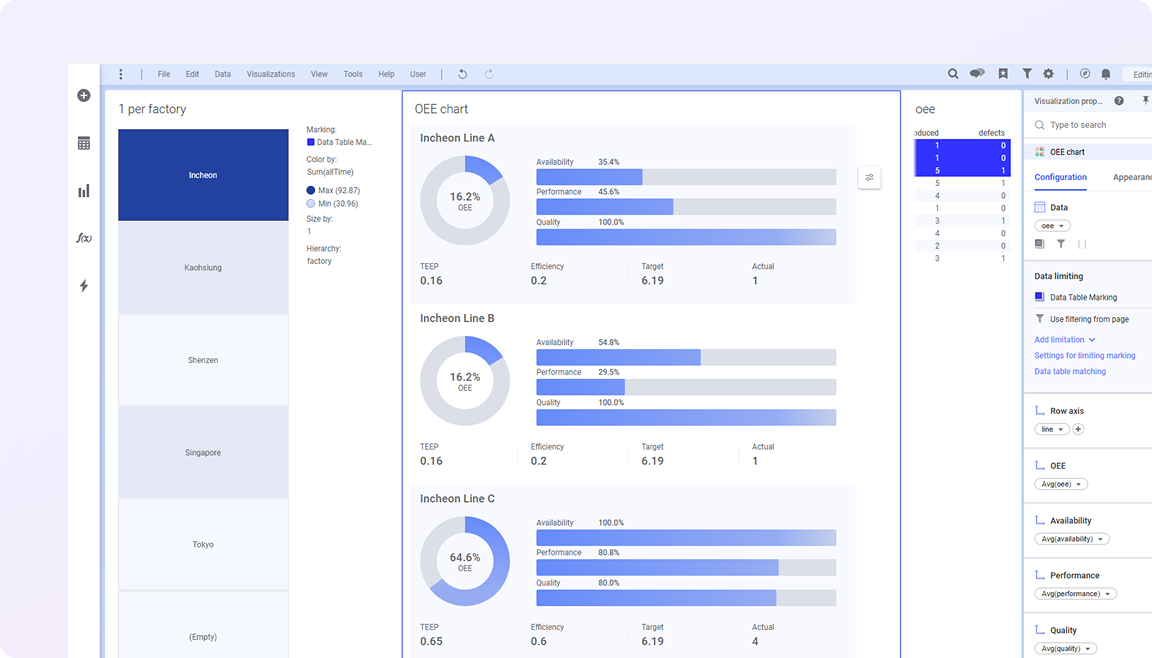
Spotfire 的作用是把这些分散在 SCADA、EAM、Excel 台账里的数据汇入同一个分析环境,按设备、时间、工况对齐,供工程师交互式探索。企业已有 MES 或数据中台时,Spotfire 直接消费治理好的数据;没有时,也可以先连接数据库和离线文件起步。
不是”超阈值报警”,而是”偏离自身基线才算异常”
传统 SCADA 报警用的是固定阈值,比如齿轮箱温度超过 90°C 才报警。问题在于:很多故障在远低于阈值的区间就已经开始发展了。
一个真实例子:某 200MW 风电场的 100 台机组,每台有 40 多个传感器点位。其中一台机组的齿轮箱温度只有 78°C,远低于 90°C 的报警线,但从历史趋势看,它每次在 78–82°C 区间波动后就会进入快速劣化阶段。固定阈值对这类”看起来正常、其实已经偏离自身基线”的状态完全无感。
Spotfire 的做法是为每台设备、每个参数建立自己的正常波动区间——按该设备过去 30 天同时段、同工况的数据计算基线,偏离 ±2σ 才自动标记。配合 GIS 地图总览(圆点大小代表功率、颜色代表健康评分),运维主任一眼就能从 100 台机组里挑出需要关注的两三台。
这个风电场实施后的效果是:齿轮箱非计划停机减少约 30%,多数故障在发生前 2–4 周就被趋势分析捕捉到。
用韦布尔曲线估算”还能用多久”
发现异常只是第一步,维护决策还需要回答”什么时候修最合适”。Spotfire 内置与 R 语言兼容的 TERR 统计引擎,可以通过数据函数运行基于韦布尔分布(Weibull)的参数化失效模型——Spotfire 官方社区提供现成的韦布尔可靠性分析组件,不需要自己从头写算法。模型用历史故障数据拟合设备的失效概率曲线,估算剩余使用寿命,从而把维护安排在”故障概率显著上升、但还没进入高风险区”的窗口内。
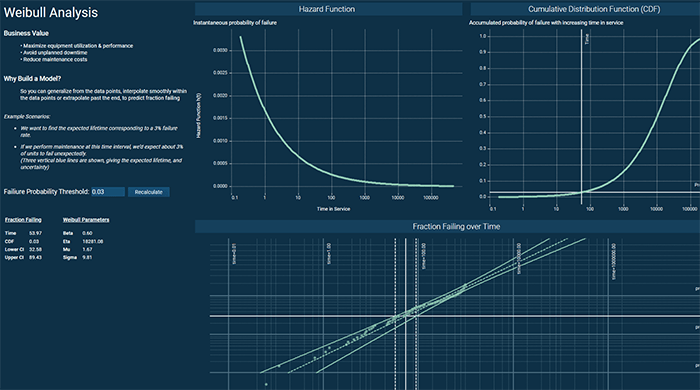
对于备件管理,这类模型还能反向回答”该备多少件”——按预测的故障分布备货,而不是按经验多备或临时加急。
三个行业的实际效果
轨道交通:CAF 的列车远程监控
西班牙列车制造与运营商 CAF 基于 Spotfire 构建了 LeadMind 平台,为铁路运营方提供基于状态的预测性维护服务。通过对车队实时数据的分析,CAF 帮助客户把故障率降低了 10–40 倍,维护成本降低约 10%。目前 LeadMind 已在 12 个国家支撑 30 多个项目,包括为英国最大的列车 franchise Northern 的 100 多列列车提供实时远程监控。
半导体:Hemlock 的厂区级设备与能耗管理
多晶硅制造商 Hemlock Semiconductor 用 Spotfire 整合了财务、生产运营和实验室数据。除质量分析从数周缩短到几小时外,通过数据化的能耗管控——把部分生产转移到用电低谷时段——每月节省约 30 万美元。占地 200 英亩的厂区全部资产通过地理空间分析实现全景管控。
离散制造:从”救火”到”计划内”
在机械加工和装配行业,常见的落地路径是先把关键设备(加工中心、注塑机、风机、空压机群)的运行数据接入,建立健康基线和异常标记,再逐步接入维保记录训练失效模型。一家部署了预测性维护方案的汽车零部件工厂,非计划停机时间减少了约 40%。
落地建议:三步走
- 第一阶段(1–2 周):选 2–3 台故障代价最高的关键设备,接入其历史离线数据和维保记录,验证”从数据里能不能看出故障前兆”;
- 第二阶段(3–4 周):建立标准化的健康基线和预警模板,培养内部能自己维护分析模型的工程师;
- 第三阶段(长期):扩展到全产线设备,接入实时数据流,把预测模型嵌入日常维护排程。
预测性维护不需要一次性大投入。从几台关键设备、几周历史数据开始验证价值,比一次性上线全套系统更稳妥。
结语
设备维护的竞争,本质上是对”设备还能撑多久”这个问题的回答精度。定期检修按日历回答,故障抢修不回答,预测性维护用数据回答。Spotfire 这类可视化数据科学平台的价值,在于把数据接入、可视化探索到统计建模放在同一个环境里:常用的回归、分类树等预测模型不需要写代码,韦布尔这类专业模型也有现成的数据函数可以复用,设备工程师能把精力放在分析判断上,而不是工具本身。
如果你的企业正在评估设备预测性维护方案,欢迎联系云睿思预约 Spotfire 演示或申请试用,我们可以用你真实的设备数据做一次小范围验证。