在临床试验支持系列的上篇中,我们介绍了 Spotfire 围绕临床试验开发的一系列分析模块。本篇聚焦其中的核心——临床数据审阅(Clinical Data Review),结合演示案例,说明这一平台如何突破传统数据分析方式的限制,实现对试验数据的深度挖掘与快速洞察。
一、临床数据的集中管理与集成
Spotfire 的第一步优势是把数据集中起来。临床试验数据主要来自 EDC 系统,此外还有各类离线文件。针对临床数据分散、口径不一、重复处理等常见问题,Spotfire 在本地部署时就把可能用到的全部临床数据整合进同一个协作平台,为后续审阅建立规范、统一的数据基础:
- 作为 Spotfire 官方技术合作伙伴,Rave、Veeva EDC 可直接从 EDC 层面接入;其他 EDC 可导出为 SAS 文件后导入 Spotfire,完成临床数据集成;
- Spotfire 原生支持 Excel、Flat Files(TXT、CSV)等普适性格式的文件。
二、临床数据审阅平台包含哪些功能模块?
Spotfire 针对临床数据审阅开发了大量标准化功能模块,下文演示的 Demo 即基于标准模板搭建;同时各模块均支持二次开发,可按试验方案做个性化定制。
1. 汇总表模块
汇总表的设计初衷,是让工作繁忙的研究人员通过关键指标快速掌握试验整体进展,提升审阅效率。标准模板覆盖了审阅中最受关注的三类信息:受试者参与状态(Disposition)、人口学特征(Demography)、疾病基线特征(Baseline Disease),以受试者数量和占比的形式直观呈现(见下图)。
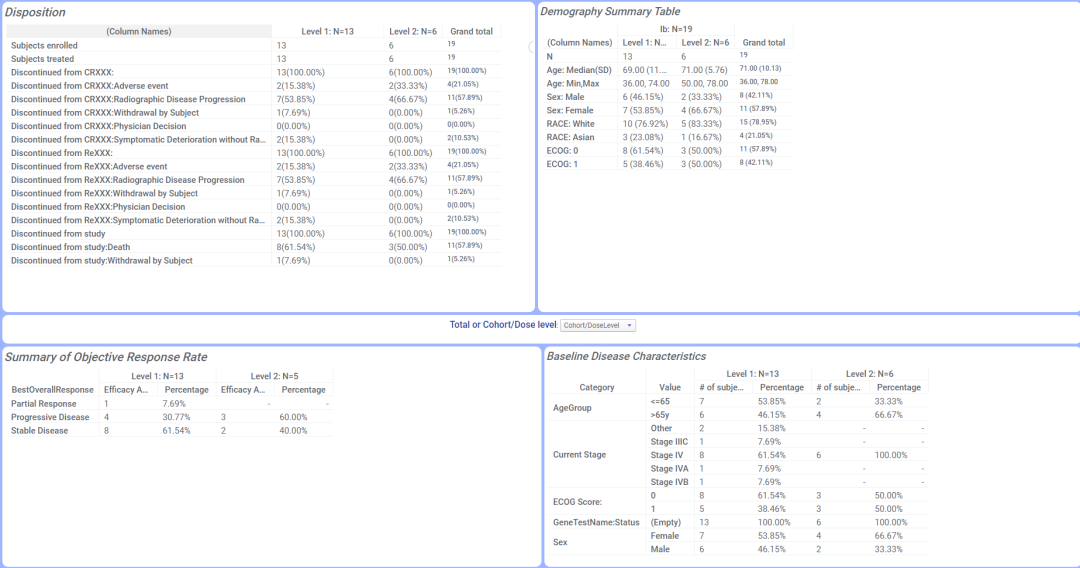
汇总表提供总体汇总和分组汇总两个视图,通过 “Total or Cohort/Dose level” 下拉选项切换:选择 Cohort/Dose level 时,数据按剂量组、治疗队列分组呈现;切换到 Total 则不分组展示,满足不同审阅视角的需求。此外还可以呈现不良事件(AE)汇总表,左侧筛选器可动态改变图表内容和人群范围;实际落地时可按试验要求增加筛选条件,做个性化定制。
2. 安全性分析模块
(1)AE(不良事件)
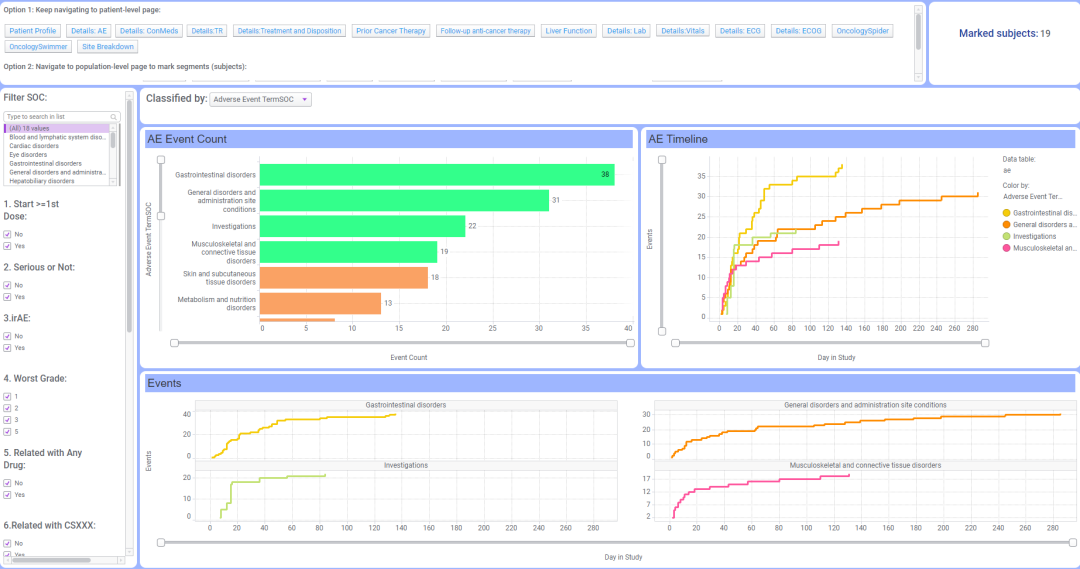
AE 汇总表起”提纲挈领”的作用,但无法下钻跳转。更具体的审阅需要进入安全性分析模块的 Adverse Event 页面:在这里可以按系统器官分类、严重程度等维度查看 AE 分布,并逐层下钻到受试者层面。
如果关注 AE 随时间的发展规律,可进入 Time to events 页面(见下图)。筛选好数据后,通过 AE Timeline 图表把所有不良事件按累积时间线排布,观察其积累趋势,快速识别集中爆发的时间窗口。
(2)Lab(实验室检查)
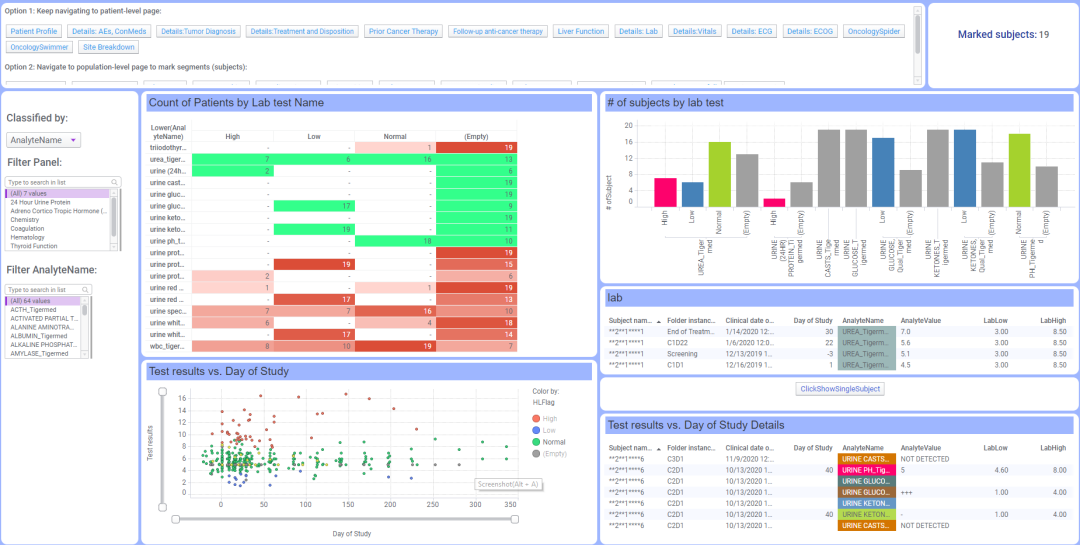
Lab 部分呈现受试者化验数据。基于最新数据更新,汇总呈现各化验项目结果的状态分布——High、Low、Normal 及空值,并支持通过交互式标记与下钻,进一步查看对应受试者及其明细数据(见下图),帮助研究人员快速锁定异常实验室指标。
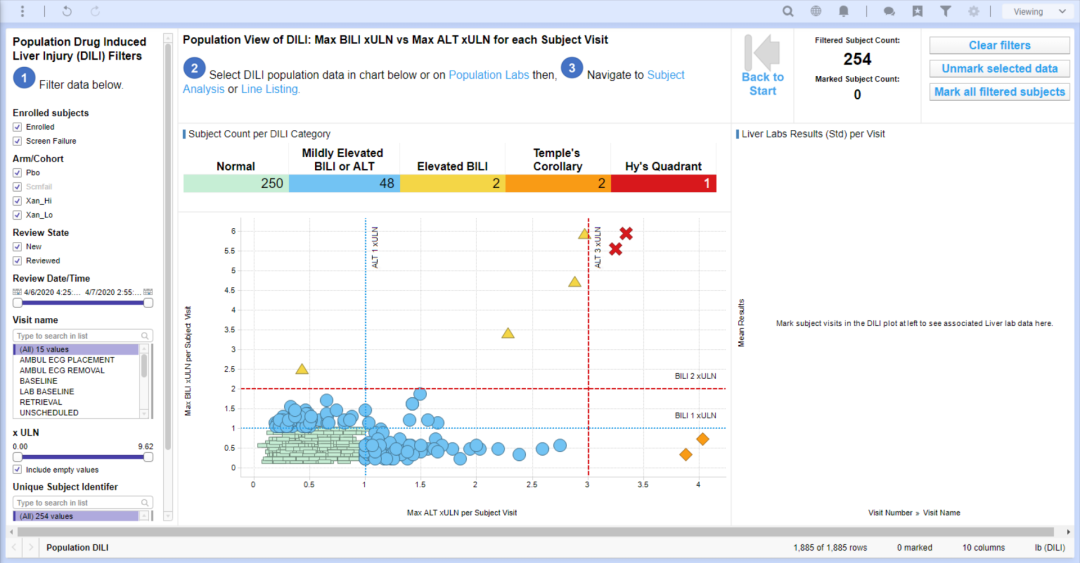
Lab 的延伸模块之一:Hy’s Law。该页面用四象限图可视化肝功能相关指标,并以醒目的颜色和图形标记潜在肝损伤高风险受试者(见下图)。研究人员可通过交互式标记快速定位异常病例,并下钻至 Patient Profile 查看受试者详细数据。
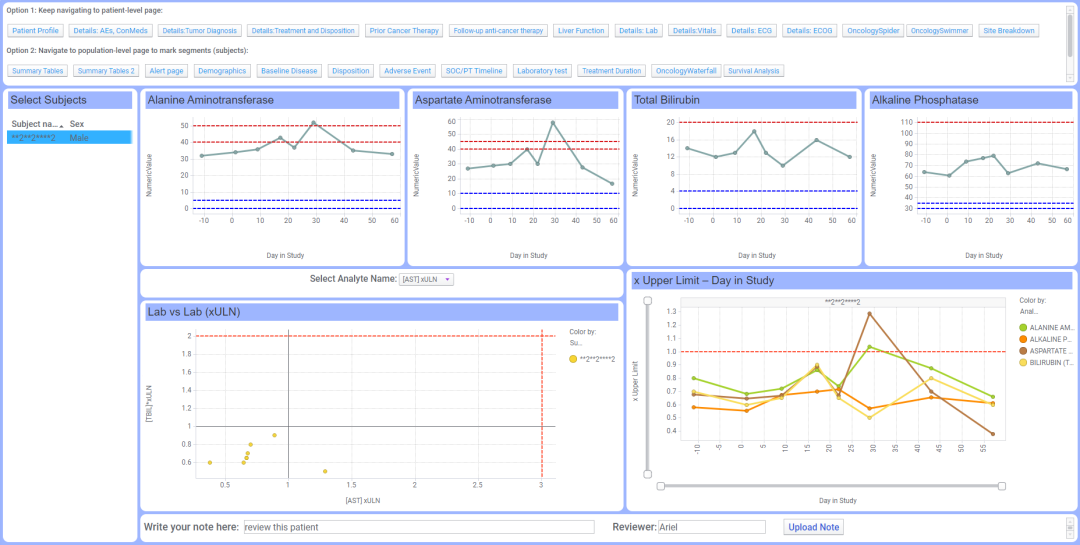
延伸模块之二:Liver Function。标记目标受试者后,可在此页面进一步查看该受试者肝功能指标随试验进程的化验变化趋势,以及当前所处的 Hy’s Law 风险象限和预警状态(见下图)。
3. 疗效性模块
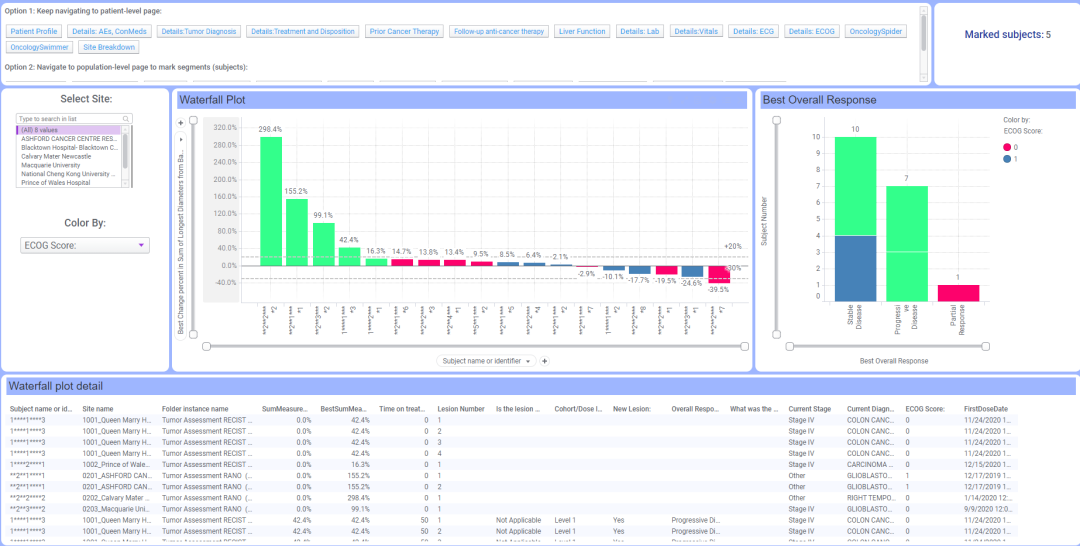
疗效性模块可审阅受试者整体缓解情况,并按量表对受试者排序(见下图)。支持标记受试者后进入后续疗效性页面深入分析。
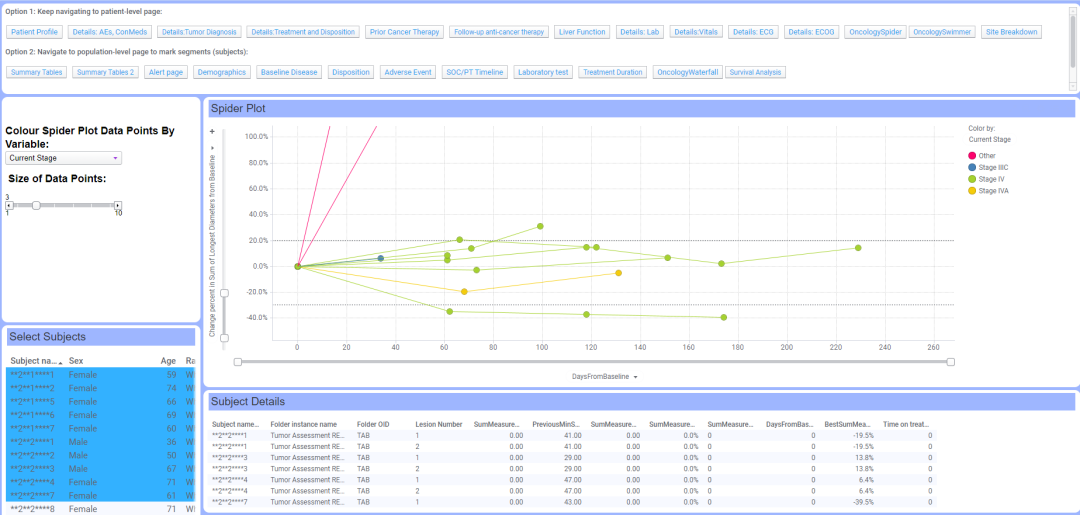
例如,发现某受试者量表较基线的变化数据良好,将其标记后,可进入 Spider Plot 界面(见下图),查看目标受试者在不同访视阶段数据变化的趋势和轨迹。
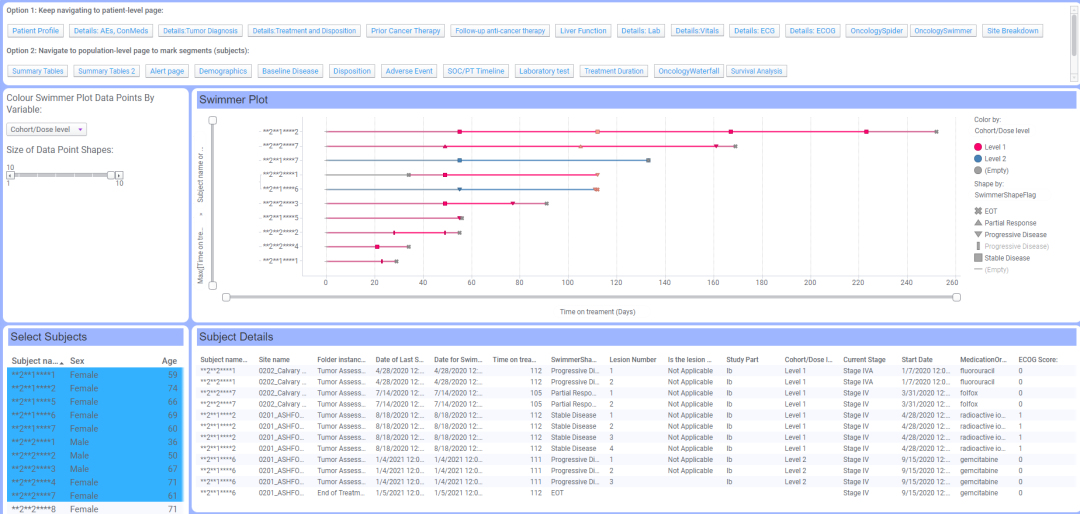
还可以把标记的受试者带入 Swimmer Plot 界面(见下图),按访视查看其在本试验中的完整发展情况:疗效变化、是否退出试验、退出原因、所处 Arm 等,并用不同颜色、形状的图标加以区分。
4. 受试者个例信息报告表
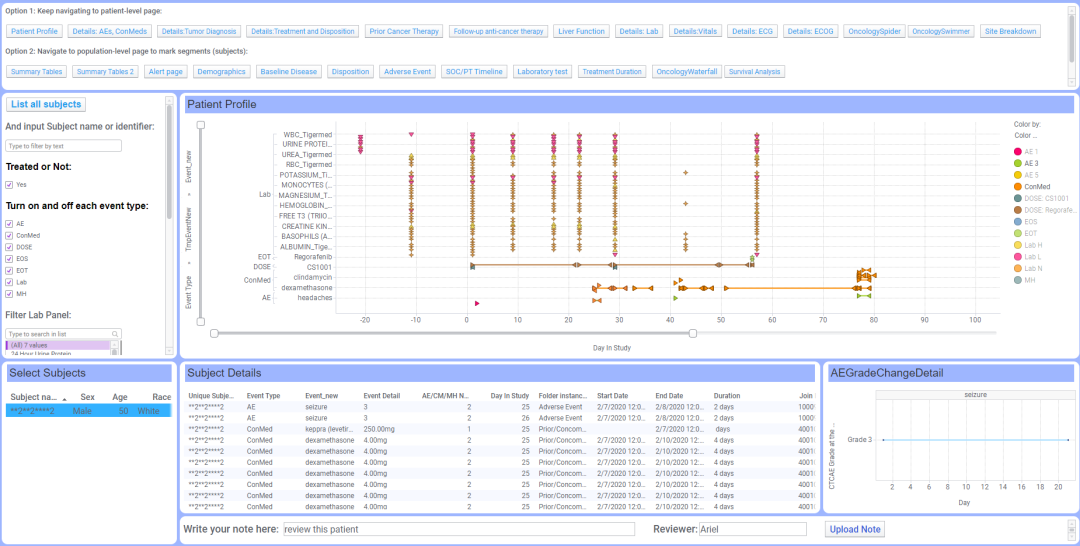
Patient Profile(受试者个例信息报告表,见下图)把同一受试者分散在各数据集里的信息汇聚到同一页面,避免在不同页面之间来回切换,是受试者级审阅的核心入口。
5. 生存分析模块
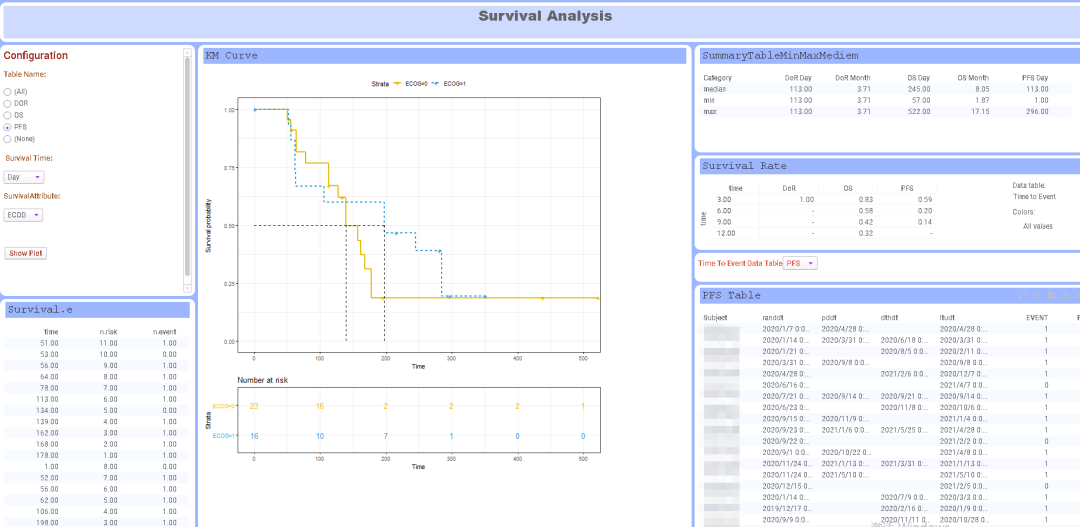
生存分析模块后台搭载统计分析功能,支持 KM 曲线、生存率等结果的展示。如果试验关注 OS、PFS 或疾病进展时间,可灵活选配(见下图)。
6. Data Listing 模块
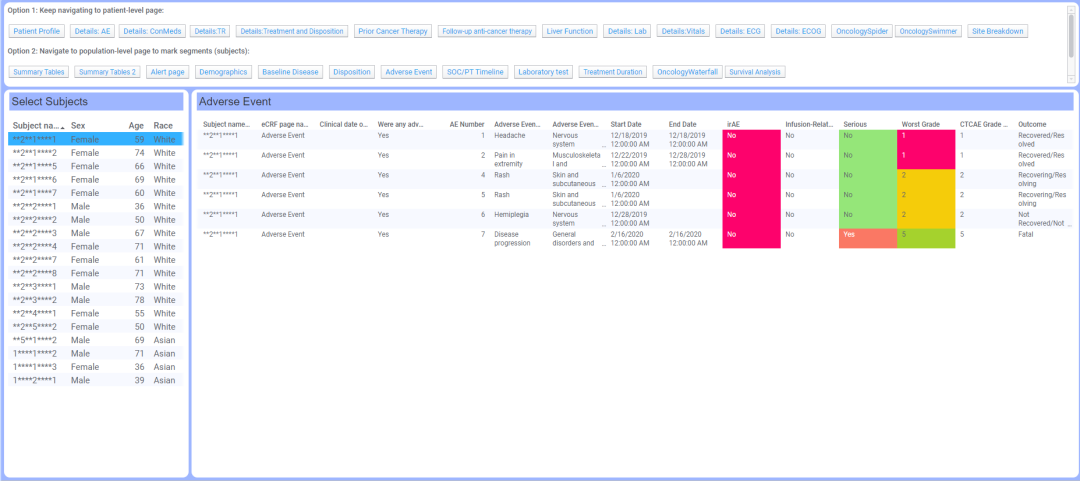
Data Listing 面向受试者个体层面的明细数据。研究人员在 Population Level 找到目标受试者子集并标记后,可进一步在 Data Listing 中查看明细表,并对关心的字段列做颜色区分(见下图)。
三、常用的分析路径
实际使用时,医学人员并不是孤立地使用某个模块,而是围绕具体医学问题把多个模块组合成完整分析链路。以下三条是常见的审阅路径。
路径一:双盲试验安慰剂效应评估
通过汇总表和趋势曲线展示不同盲态 Arm、对应访视时间下各量表相对基线的变化情况及 responder 比例。当重点关注某一量表或受试者时,下钻到个体患者界面综合评估疗效变化。
- 汇总表模块 + 趋势曲线 + Patient Profile + Data Listing + 疗效评估模块 + 组间比较
路径二:神经科多量表内在一致性监测
对多个量表之间的相关性及变化趋势做综合分析,辅助识别量表结果之间可能存在的不一致,并定位需要重点审阅的受试者。在路径一的基础上,增加量表间一致性系数热图、散点图及拟合回归线,帮助医学人员快速定位不一致的量表和受试者,带入 Patient Profile 或 SD 监测页面做进一步分析。
路径三:量表分数 SD 监测
持续监测各中心量表 SD 随访视的变化趋势,以及当前访视下各中心 SD 排名和异常情况,辅助识别明显偏离的中心,进一步定位需要重点关注的量表或受试者。
- SD 趋势折线图 + 中心 SD 排名 + Box Plot + 中心量表 Heatmap + 异常中心患者清单(标记后跳转)
从研究整体、研究中心、具体量表到个体受试者逐层下钻,可快速缩小异常范围,提高量表数据审阅和中心级风险识别的效率。
四、常见问题答疑
Q1:搭建和使用过程中,临床试验团队的程序员需要做哪些工作?
主要有两方面:一是模板搭建阶段,向 Spotfire 技术团队提供医学团队统计分析的脚本语言、版本等信息,确保前台呈现结果与后续回溯性分析保持一致;二是投入使用后,当数据刷新导致结果变化或出现异常时,从统计分析角度协助医学用户解读结果。临床研究人员在日常使用中不涉及任何代码和脚本。
Q2:所有安全性、疗效性模块都需要定制化吗?
不是。上文演示的 Demo 就完全基于标准化模板搭建,筛选器和下拉框均不含定制化内容。定制化要求不高的部分直接使用标准模板即可——标准化程度越高,个性化适配和开发工作越少,实施、验证和上线周期也相应更短。
Q3:不同系统导入的数据,能在同一个 Subject 页面集中查看吗?
可以。只要各数据源中用于识别患者的唯一标识(如 Subject ID/Name)保持一致,系统会把相关数据自动归并到同一患者的 Patient Profile 中。在筛选器中定制添加需要关注的指标后,即可在同一页面并行审阅,无需来回切换。